简述
蒙特卡罗方法是一种用多次取样来逐渐逼近样本真实分布的方法。
另外蒙特卡罗并不是人的名字,而是位于摩纳哥的一个赌场的名字。
简单的例子
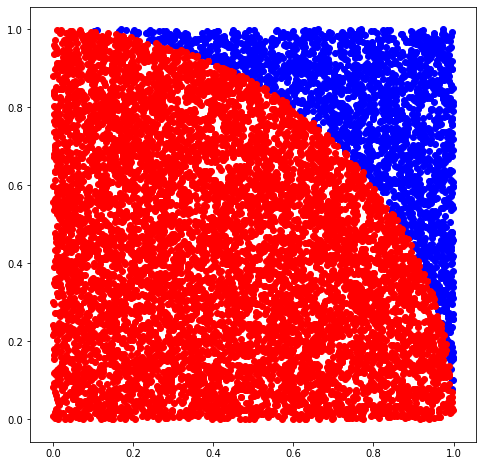
最经典的例子应该是几何概型中的算π \pi π
通过多次随机取样,取样点会随机分布在一个正方形的区域里,然后在该区域中画圆,就会是样本分成两部分。一部分在圆内,另一部分在圆外。然后通过算圆内的样本数占总样本数的比例可以近似算的圆的面积,最后通过圆面积公式能算得π \pi π
实操
1 4 S = 1 4 π R 2 = n N n : 圆内区域的样本数 N : 样本总数 \frac{1}{4}S =\frac{1}{4}\pi R^{2} = \frac{n}{N} \\ n:圆内区域的样本数 \\ N:样本总数
4 1 S = 4 1 π R 2 = N n n : 圆内区域的样本数 N : 样本总数
import random
sampleNum = 10000
counter = 0
plt. figure( figsize= ( 8 , 8 ) )
x1 = list ( )
y1 = list ( )
x2 = list ( )
y2 = list ( )
for i in range ( sampleNum) :
x = random. random( )
y = random. random( )
if x** 2 + y** 2 < 1 :
counter += 1
x1. append( x)
y1. append( y)
else :
x2. append( x)
y2. append( y)
print ( 4 * counter/ sampleNum)
plt. scatter( x2, y2, color= 'b' )
plt. scatter( x1, y1, color= 'r' )
plt. show( )
随着s a m p l e N u m sampleNum s am pl e N u m
蒙特卡罗求积分
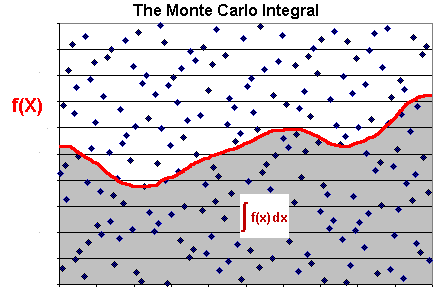
对于一个函数f ( x ) f(x) f ( x ) x ∈ [ a , b ] x\in [a, b] x ∈ [ a , b ]
比如说我们现在打算求f ( x ) f(x) f ( x ) x ∈ [ a , b ] x \in [a, b] x ∈ [ a , b ] f ( x ) ≥ 0 f(x) \ge 0 f ( x ) ≥ 0 U ≥ s u p x ∈ [ a , b ] f ( x ) U \ge \mathrm{sup}_{x \in [a, b]} f(x) U ≥ sup x ∈ [ a , b ] f ( x ) X ∼ U n i f ( a , b ) X \sim \mathrm{Unif}(a, b) X ∼ Unif ( a , b ) Y ∼ U n i f ( 0 , U ) Y \sim \mathrm{Unif}(0, U) Y ∼ Unif ( 0 , U ) { x i , x j } \{x_{i}, x_{j}\} { x i , x j }
∫ a b f ( x ) d x = ∑ ( x i , y i ) δ ( y i ≤ f ( x i ) ) N t o l \int_{a}^{b}f(x)dx = \frac{\sum_{(x_{i}, y_{i})}\delta_{(y_{i} \le f(x_{i}))}}{N_{tol}}
∫ a b f ( x ) d x = N t o l ∑ ( x i , y i ) δ ( y i ≤ f ( x i ))
上面的过程中,我们需要对两个变量进行采样,那么是否可以只对一个变量进行采样的方法呢?
回想一下黎曼积分的思想,我们可以将积分看作在x x x X ∼ U n i f ( a , b ) X\sim \mathrm{Unif}(a, b) X ∼ Unif ( a , b ) { x i } N \{x_{i}\}_{N} { x i } N
∫ a b f ( x ) d x = ∑ i N f ( x i ) b − a N , \int_{a}^{b} f(x) dx = \sum_{i}^{N}f(x_{i}) \frac{b-a}{N},
∫ a b f ( x ) d x = i ∑ N f ( x i ) N b − a ,
其中b − a N \frac{b-a}{N} N b − a d x dx d x Y Y Y
蒙特卡罗求期望
对于一个函数f ( x ) f(x) f ( x ) x x x E x ∼ π ( x ) [ f ( x ) ] \mathbb{E}_{x\sim\pi(x)}[f(x)] E x ∼ π ( x ) [ f ( x )] π ( x ) \pi(x) π ( x ) X X X
E x ∼ π ( x ) [ f ( x ) ] = ∫ x π ( x ) f ( x ) d x . \mathbb{E}_{x\sim \pi(x)}[f(x)] = \int_{x}\pi(x)f(x) dx.
E x ∼ π ( x ) [ f ( x )] = ∫ x π ( x ) f ( x ) d x .
假设我们对X X X { x i } N \{x_{i}\}_{N} { x i } N
E x ∼ π ( x ) [ f ( x ) ] = 1 N ∑ i N f ( x i ) . \mathbb{E}_{x\sim \pi(x)}[f(x)] = \frac{1}{N}\sum_{i}^{N}f(x_{i}).
E x ∼ π ( x ) [ f ( x )] = N 1 i ∑ N f ( x i ) .
举例来讲,如果现在X ∼ U n i f ( a , b ) X \sim \mathrm{Unif}(a, b) X ∼ Unif ( a , b )
E x ∼ π ( x ) [ f ( x ) ] = ∫ x 1 b − a f ( x ) d x = 1 N ∑ i N f ( x i ) . \mathbb{E}_{x\sim \pi(x)}[f(x)] = \int_{x}\frac{1}{b-a}f(x) dx = \frac{1}{N}\sum_{i}^{N}f(x_{i}).
E x ∼ π ( x ) [ f ( x )] = ∫ x b − a 1 f ( x ) d x = N 1 i ∑ N f ( x i ) .
重要性采样
有的时候直接从目标分布(注意,这个分布是已知的)采样非常困难,代价高昂,或者一定样本的到的精度不高时。
我们可以引入一个容易采样的建议分布(Proposal Distribution),并赋予每个样本相应的权重,来无偏地估计目标分布的期望值。
假设我们选择的易于采样的建议分布的pdf为q ( x ) q(x) q ( x )
E x ∼ π ( x ) [ f ( x ) ] = ∫ x π ( x ) f ( x ) d x = ∫ x q ( x ) π ( x ) q ( x ) f ( x ) d x = E x ∼ q ( x ) [ π ( x ) q ( x ) f ( x ) ] . \begin{aligned}
\mathbb{E}_{x\sim \pi(x)}[f(x)] &= \int_{x}\pi(x)f(x) dx\\
&= \int_{x}q(x)\frac{\pi(x)}{q(x)}f(x) dx \\
&= \mathrm{E}_{x \sim q(x)}\left[\frac{\pi(x)}{q(x)}f(x)\right].
\end{aligned}
E x ∼ π ( x ) [ f ( x )] = ∫ x π ( x ) f ( x ) d x = ∫ x q ( x ) q ( x ) π ( x ) f ( x ) d x = E x ∼ q ( x ) [ q ( x ) π ( x ) f ( x ) ] .
如果我们把π ( x ) q ( x ) \frac{\pi(x)}{q(x)} q ( x ) π ( x ) w ( x ) w(x) w ( x )
E x ∼ q ( x ) [ π ( x ) q ( x ) f ( x ) ] = E x ∼ q ( x ) [ w ( x ) f ( x ) ] \mathrm{E}_{x \sim q(x)}\left[\frac{\pi(x)}{q(x)}f(x)\right] = \mathrm{E}_{x \sim q(x)}\left[w(x)f(x)\right]
E x ∼ q ( x ) [ q ( x ) π ( x ) f ( x ) ] = E x ∼ q ( x ) [ w ( x ) f ( x ) ]
可以看作我们在建议分布上采样的时候,目标函数f ( x ) f(x) f ( x ) w ( x ) w(x) w ( x ) x x x f ( x ) f(x) f ( x )
对X X X
E x ∼ q ( x ) [ w ( x ) f ( x ) ] = 1 N ∑ i N w ( x i ) f ( x i ) . \mathrm{E}_{x \sim q(x)}\left[w(x)f(x)\right] = \frac{1}{N}\sum_{i}^{N}w(x_{i})f(x_{i}).
E x ∼ q ( x ) [ w ( x ) f ( x ) ] = N 1 i ∑ N w ( x i ) f ( x i ) .
与上面的直观理解相似,“重要性”体现在,对于不同x i x_{i} x i w ( x i ) w(x_{i}) w ( x i ) f ( x i ) f(x_{i}) f ( x i ) π ( x ) \pi(x) π ( x ) q ( x ) q(x) q ( x ) f ( x ) f(x) f ( x ) f ( x ) f(x) f ( x )
拒绝采样
重要性采样是对目标函数f ( x ) f(x) f ( x ) { x i } N \{x_{i}\}_{N} { x i } N
因为目标分布的直接采样困难,
在拒绝采样的过程中,我们还是要先选取一个易于采样的建议分布q ( x ) q(x) q ( x ) M M M
M ⋅ q ( x ) ≥ π ( x ) . M\cdot q(x) \ge \pi(x).
M ⋅ q ( x ) ≥ π ( x ) .
自然,我们接下来应该做的是直接从q ( x ) q(x) q ( x ) x i x_{i} x i α a c c e p t \alpha_{\mathrm{accept}} α accept α r e j e c t = 1 − α a c c e p t \alpha_{\mathrm{reject}} = 1 - \alpha_{\mathrm{accept}} α reject = 1 − α accept
对于x i x_{i} x i
α a c c e p t = π ( x i ) M ⋅ q ( x i ) . \alpha_{\mathrm{accept}} = \frac{\pi(x_{i})}{M\cdot q(x_{i})}.
α accept = M ⋅ q ( x i ) π ( x i ) .
为了实现概率接受和概率丢弃,我们可以随机生成一个服从U n i f ( 0 , 1 ) \mathrm{Unif}(0, 1) Unif ( 0 , 1 ) u u u u u u [ 0 , α a c c e p t ] [0, \alpha_{\mathrm{accept}}] [ 0 , α accept ] x i x_{i} x i u ∈ ( α a c c e p t , 1 ] u \in (\alpha_{\mathrm{accept}}, 1] u ∈ ( α accept , 1 ] x i x_{i} x i
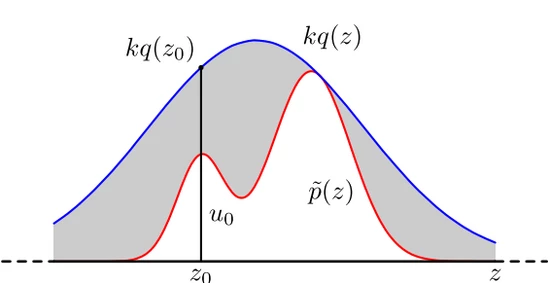
拒绝采样的直觉理解是很简单的,
图中,p ~ ( z ) \tilde{p}(z) p ~ ( z ) π ( x ) \pi(x) π ( x ) k k k q ( z ) q(z) q ( z ) M M M q ( x ) q(x) q ( x ) z 0 z_{0} z 0 z 0 z_0 z 0 p ~ ( z ) \tilde{p}(z) p ~ ( z ) k q ( z ) kq(z) k q ( z ) z 0 z_{0} z 0
MCMC
拒绝采样适用于低维简单分布,而 MCMC 专为高维复杂分布设计,通过构建马尔可夫链使其平稳分布收敛于目标分布。
MCMC采样很神奇的点在于,每次采样的时候不是完全独立,而是上一个采样的样本会对下一采样的样本有一定约束。
马尔可夫链
对于一组随机变量X = { X t } t ≥ 0 \boldsymbol{X} = \{X_{t}\}_{t \ge 0} X = { X t } t ≥ 0 t t t
P ( X t ∣ { X t } 0 ≤ t ≤ t − 1 ) = P ( X t ∣ X t − 1 ) , P(X_{t} \mid \{X_{t}\}_{0 \le t \le t-1}) = P(X_{t} \mid X_{t-1}),
P ( X t ∣ { X t } 0 ≤ t ≤ t − 1 ) = P ( X t ∣ X t − 1 ) ,
那么,称X = { X t } t ≥ 0 \boldsymbol{X} = \{X_{t}\}_{t \ge 0} X = { X t } t ≥ 0 P ( X t ∣ X t − 1 ) P(X_{t}\mid X_{t-1}) P ( X t ∣ X t − 1 ) X t − 1 X_{t-1} X t − 1 X t X_{t} X t
例如,我们在这里假设X ≤ t = { X t } ≤ t ∈ [ 1 , 2 , 3 ] ( t + 1 ) \boldsymbol{X}_{\le t} = \{X_{t}\}_{\le t} \in [1, 2, 3]^{(t+1)} X ≤ t = { X t } ≤ t ∈ [ 1 , 2 , 3 ] ( t + 1 )
P = [ p 11 p 12 p 13 p 21 p 22 p 23 p 31 p 32 p 33 ] , \begin{aligned}
\boldsymbol{P} =
\left[
\begin{array}{ccc}
p_{11} & p_{12} & p_{13} \\
p_{21} & p_{22} & p_{23} \\
p_{31} & p_{32} & p_{33}
\end{array}
\right],
\end{aligned}
P = p 11 p 21 p 31 p 12 p 22 p 32 p 13 p 23 p 33 ,
其中,P j i = P ( X t = j ∣ X t − 1 = i ) P_{ji} = P(X_{t}=j \mid X_{t-1}=i) P j i = P ( X t = j ∣ X t − 1 = i )
我们进一步定义
π ( t ) = [ π 1 ( t ) , π 2 ( t ) , π 3 ( t ) ] ⊤ , \pi(t) = [\pi_{1}(t), \pi_{2}(t), \pi_{3}(t)]^{\top},
π ( t ) = [ π 1 ( t ) , π 2 ( t ) , π 3 ( t ) ] ⊤ ,
为t t t π i ( t ) = P ( X t = i ) \pi_{i}(t) = P(X_{t}=i) π i ( t ) = P ( X t = i ) π ( t ) = [ π 1 ( t ) , π 2 ( t ) , π 3 ( t ) ] \pi(t) = [\pi_{1}(t), \pi_{2}(t), \pi_{3}(t)] π ( t ) = [ π 1 ( t ) , π 2 ( t ) , π 3 ( t )] t t t π t \pi_{t} π t
π ( t ) ⊤ = π ( 0 ) ⊤ P t . \pi(t)^{\top} = \pi(0)^{\top}P^{t}.
π ( t ) ⊤ = π ( 0 ) ⊤ P t .
我们都知道,对于一个转移过程,若
π ( t ) ⊤ = π ( t ) ⊤ P , \pi(t)^{\top} = \pi(t)^{\top}P,
π ( t ) ⊤ = π ( t ) ⊤ P ,
则称π ( t ) \pi(t) π ( t )
一个马尔可夫链拥有唯一平稳分布通常需要具备一下三点性质:
不可约性(Irreducible):系统中的任何一个状态都可以通过有限步转移到达其他所有状态。
非周期性(Aperiodic):系统从某状态出发,返回该状态的可能步数不具有公约数,避免了系统出现死循环振荡。
正常返性(Positive Recurrent):系统平均返回到某一状态的时间是有限的。
最后,我们定义一种特殊的马尔可夫链。
对于任意时刻t t t
∀ i ∀ j , p j i π i = p i j π j , \forall i \forall j, \qquad p_{ji}\pi_{i} = p_{ij}\pi_{j},
∀ i ∀ j , p j i π i = p ij π j ,
则称该马尔可夫链为可逆马尔可夫链。
定理 1 π \pi π
MCMC采样
如定理1 所言,我们只要能找到一个满足细致平衡方程的P \boldsymbol{P} P π \pi π
接下来的问题变成如何去寻找满足条件的P \boldsymbol{P} P
我们可以先任取一个转移矩阵Q \boldsymbol{Q} Q
π i q j i ≠ π j q i j . \pi_{i}q_{ji} \ne \pi_{j}q_{ij}.
π i q j i = π j q ij .
但我们可以在不等式两边进行适当缩放,然后不等式变为等式
π i q j i α j i = π j q i j α i j , \pi_{i}q_{ji}\alpha_{ji} = \pi_{j}q_{ij}\alpha_{ij},
π i q j i α j i = π j q ij α ij ,
其中α j i \alpha_{ji} α j i α i j \alpha_{ij} α ij
进一步,要是等式恒成立,我们可以简单地令
α j i = π j q i j , α i j = π i q j i . \alpha_{ji} = \pi_{j}q_{ij}, \qquad \alpha_{ij} = \pi_{i}q_{ji}.
α j i = π j q ij , α ij = π i q j i .
此时,等式两边都为π j ⋅ q i j ⋅ π i ⋅ q j i \pi_{j}\cdot q_{ij}\cdot \pi_{i}\cdot q_{ji} π j ⋅ q ij ⋅ π i ⋅ q j i
最后,如果我们把
α i q j i \alpha_{i}q_{ji} α i q j i q ~ j i \tilde{q}_{ji} q ~ j i α j q i j \alpha_{j}q_{ij} α j q ij q ~ i j \tilde{q}_{ij} q ~ ij
π i q ~ j i = π j q ~ i j . \pi_{i}\tilde{q}_{ji} = \pi_{j}\tilde{q}_{ij}.
π i q ~ j i = π j q ~ ij .
注意这里的平稳分布是π i \pi_{i} π i π j \pi_{j} π j q ~ j i \tilde{q}_{ji} q ~ j i q ~ i j \tilde{q}_{ij} q ~ ij
那么,我们是否还可以用Q ~ \widetilde{\boldsymbol{Q}} Q p j i p_{ji} p j i q ~ j i \tilde{q}_{ji} q ~ j i
p j i = { q ~ j i , i ≠ j , q ~ j i + ( 1 − ∑ j ∈ s u p p ( X ) q ~ j i ) , j = i . \begin{aligned}
p_{ji} =
\left\{
\begin{array}{ll}
\tilde{q}_{ji}, & i \ne j, \\
\tilde{q}_{ji} + (1 - \sum_{j \in \mathrm{supp}(\boldsymbol{X})}\tilde{q}_{ji}), & j = i.
\end{array}
\right.
\end{aligned}
p j i = { q ~ j i , q ~ j i + ( 1 − ∑ j ∈ supp ( X ) q ~ j i ) , i = j , j = i .
等价的
p j i = q ~ j i + ( 1 − ∑ j ∈ s u p p ( X ) q ~ j i ) δ i = j . p_{ji} = \tilde{q}_{ji} + (1 - \sum_{j \in \mathrm{supp}(\boldsymbol{X})}\tilde{q}_{ji})\delta_{i=j}.
p j i = q ~ j i + ( 1 − j ∈ supp ( X ) ∑ q ~ j i ) δ i = j .
直觉上,我们可以认为当两次采样的状态(值)不一样的时候,直接用q ~ j i \tilde{q}_{ji} q ~ j i p j i p_{ji} p j i i = j i=j i = j q ~ i i \tilde{q}_{ii} q ~ ii p i i p_{ii} p ii ∑ j ∈ s u p p ( X ) q ~ j i \sum_{j \in \mathrm{supp}(\boldsymbol{X})}\tilde{q}_{ji} ∑ j ∈ supp ( X ) q ~ j i 1 1 1 p j i p_{ji} p j i
至于这样的p j i p_{ji} p j i π i \pi_{i} π i π j \pi_{j} π j f i , j f_{i, j} f i , j f j , i f_{j,i} f j , i
f i , j δ i = j π i = f j , i δ i = j π j . f_{i, j}\delta_{i=j}\pi_{i} = f_{j, i}\delta_{i=j}\pi_{j}.
f i , j δ i = j π i = f j , i δ i = j π j .
具体来说,当i ≠ j i \ne j i = j i = j i = j i = j f i , i π i = f j , j π j f_{i, i}\pi_{i} = f_{j, j}\pi_{j} f i , i π i = f j , j π j Q ~ \widetilde{\boldsymbol{Q}} Q i = j i=j i = j P \boldsymbol{P} P
一言蔽之就是说,通过调整转移矩阵的对角线元素可以完成归一化,并且不影响细致平稳条件的成立。
Metropolis算法
接下来写一下到目前为止的算法。
我们的目标实在满足细致平衡条件的Q ~ \widetilde{\boldsymbol{Q}} Q Q ~ \widetilde{\boldsymbol{Q}} Q Q \boldsymbol{Q} Q q ~ j i \widetilde{q}_{ji} q j i q j i {q}_{ji} q j i α j i \alpha_{ji} α j i q j i {q}_{ji} q j i i i i j j j i ≠ j i \ne j i = j q ~ j i \tilde{q}_{ji} q ~ j i α j i \alpha_{ji} α j i i i i i i i j j j α j i \alpha_{ji} α j i 1 − α j i 1-\alpha_{ji} 1 − α j i j j j i i i i i i
需要注意的是,我们由状态i i i i i i α i i \alpha_{ii} α ii 1 − α j i 1-\alpha_{ji} 1 − α j i p j i p_{ji} p j i
最后,Metropolis算法总结如下
Metropolis采样 初始状态的x 0 x_{0} x 0 x t x_{t} x t x t + 1 x_{t+1} x t + 1
通过q t + 1 , t q_{t+1, t} q t + 1 , t x t + 1 ∗ x^{*}_{t+1} x t + 1 ∗
从U n i f ( 0 , 1 ) \mathrm{Unif}(0, 1) Unif ( 0 , 1 ) u u u
如果u ≤ α t + 1 , t u \le \alpha_{t+1, t} u ≤ α t + 1 , t x t + 1 ← α t + 1 , t ⋅ x t + 1 ∗ x_{t+1} \gets \alpha_{t+1, t} \cdot x^{*}_{t+1} x t + 1 ← α t + 1 , t ⋅ x t + 1 ∗ x t + 1 ← x t x_{t+1} \gets x_{t} x t + 1 ← x t
这个算法与拒绝采样相似,但不完全一直。
拒绝采样中如果样本被拒绝那就是拒绝了,但Metropolis算法的话,会把原地踏步把目前的状态计入时刻t t t
Metropolis-Hastings 采样
通过α j i \alpha_{ji} α j i α j i \alpha_{ji} α j i
为了解决这个问题,我们先回到细致平稳方程
π i q j i α j i = π j q i j α i j . \pi_{i}q_{ji}\alpha_{ji} = \pi_{j}q_{ij}\alpha_{ij}.
π i q j i α j i = π j q ij α ij .
正如我前面所说,α j i \alpha_{ji} α j i α i j \alpha_{ij} α ij c i c_{i} c i c i ⋅ α j i c_{i}\cdot \alpha_{ji} c i ⋅ α j i c i c_{i} c i c i ⋅ α j i c_{i}\cdot \alpha_{ji} c i ⋅ α j i c i ⋅ α i j c_{i}\cdot \alpha_{ij} c i ⋅ α ij c i ⋅ α j i c_{i}\cdot \alpha_{ji} c i ⋅ α j i c i ⋅ α j i = 1 c_{i}\cdot \alpha_{ji} = 1 c i ⋅ α j i = 1 c i ⋅ α i j = 1 c_{i}\cdot \alpha_{ij}=1 c i ⋅ α ij = 1
令A j i : = c i ⋅ α j i \mathcal{A}_{ji}:=c_{i}\cdot \alpha_{ji} A j i := c i ⋅ α j i
A j i = { 1 , α j i ≥ α i j , π j q i j π i q j i , α j i < α i j . \begin{aligned}
\mathcal{A}_{ji} =
\left\{
\begin{array}{ll}
1, & \alpha_{ji} \ge \alpha_{ij},\\
\frac{\pi_{j}q_{ij}}{\pi_{i}q_{ji}}, & \alpha_{ji} < \alpha_{ij}.
\end{array}
\right.
\end{aligned}
A j i = { 1 , π i q j i π j q ij , α j i ≥ α ij , α j i < α ij .
最后,我们只需要让新的接受率
A j i = m i n ( 1 , π j q i j π i q j i ) \mathcal{A}_{ji} = \mathrm{min}(1, \frac{\pi_{j}q_{ij}}{\pi_{i}q_{ji}})
A j i = min ( 1 , π i q j i π j q ij )
就好。
如果,q i j = q j i q_{ij} = q_{ji} q ij = q j i
A j i = m i n ( 1 , π j π i ) \mathcal{A}_{ji} = \mathrm{min}(1, \frac{\pi_{j}}{\pi_{i}})
A j i = min ( 1 , π i π j )
Metropolis-Hastings 采样 初始状态的x 0 x_{0} x 0 x t x_{t} x t x t + 1 x_{t+1} x t + 1
通过q t + 1 , t q_{t+1, t} q t + 1 , t x t + 1 ∗ x^{*}_{t+1} x t + 1 ∗
从U n i f ( 0 , 1 ) \mathrm{Unif}(0, 1) Unif ( 0 , 1 ) u u u
如果u ≤ A t + 1 , t = m i n ( 1 , π t + 1 q t , t + 1 π t q t + 1 , t ) u \le \mathcal{A}_{t+1, t}=\mathrm{min}(1, \frac{\pi_{t+1}q_{t, t+1}}{\pi_{t}q_{t+1, t}}) u ≤ A t + 1 , t = min ( 1 , π t q t + 1 , t π t + 1 q t , t + 1 ) x t + 1 ← α t + 1 , t ⋅ x t + 1 ∗ x_{t+1} \gets \alpha_{t+1, t} \cdot x^{*}_{t+1} x t + 1 ← α t + 1 , t ⋅ x t + 1 ∗ x t + 1 ← x t x_{t+1} \gets x_{t} x t + 1 ← x t
一段M-H采样高斯分布的python 代码
import random
import math
from scipy. stats import norm
import matplotlib. pyplot as plt
def norm_dist_prob ( theta) :
y = norm. pdf( theta, loc= 10 , scale= 5 )
return y
T = 5000
pi = [ 0 for i in range ( T) ]
sigma = 1
t = 0
while t < T- 1 :
t = t + 1
pi_star = norm. rvs( loc= pi[ t - 1 ] , scale= sigma, size= 1 , random_state= None )
alpha = min ( 1 , ( norm_dist_prob( pi_star[ 0 ] ) / norm_dist_prob( pi[ t - 1 ] ) ) )
u = random. uniform( 0 , 1 )
if u < alpha:
pi[ t] = pi_star[ 0 ]
else :
pi[ t] = pi[ t - 1 ]
plt. scatter( pi, norm. pdf( pi, loc= 10 , scale= 5 ) , label= 'Target Distribution' , c= 'red' )
num_bins = 50
plt. hist( pi, num_bins, density= 1 , facecolor= 'green' , alpha= 0.7 , label= 'Samples Distribution' )
plt. legend( )
plt. show( ) 吉布斯采样(Gibbs Sampling)
接下来,我们看看更现实的应用场景,高维数据的情况。
假设X t = { X t , 1 , X t , 2 , ⋯ , X t , d } \boldsymbol{X}_{t}= \{X_{t, 1}, X_{t, 2}, \cdots, X_{t, d}\} X t = { X t , 1 , X t , 2 , ⋯ , X t , d } d d d t t t d d d h h h t + 1 t+1 t + 1 X t + 1 = X t , [ X t , h = X t + 1 , h ] \boldsymbol{X}_{t+1} = \boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]} X t + 1 = X t , [ X t , h = X t + 1 , h ]
q ( X t + 1 ∣ X t ) = P ( X t + 1 , h ∣ X t , − h ) = P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , − h ) , q(\boldsymbol{X}_{t+1} \mid \boldsymbol{X}_{t}) = P(X_{t+1, h} \mid \boldsymbol{X}_{t, -h})= \frac{P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})}{P(\boldsymbol{X}_{t, -h})},
q ( X t + 1 ∣ X t ) = P ( X t + 1 , h ∣ X t , − h ) = P ( X t , − h ) P ( X t , [ X t , h = X t + 1 , h ] ) ,
其中X t , − h = X t ∖ { X t , h } \boldsymbol{X}_{t, -h} = \boldsymbol{X}_{t} \setminus \{X_{t, h}\} X t , − h = X t ∖ { X t , h } h h h h h h
A t + 1 , t : = m i n ( 1 , P ( X t + 1 ) q ( X t ∣ X t + 1 ) P ( X t ) q ( X t + 1 ∣ X t ) ) = m i n ( 1 , P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , h ∣ X t , − h ) P ( X t ) P ( X t , h ∣ X t , − h ) ) = m i n ( 1 , P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , h ∣ X t , − h ) P ( X t , − h ) P ( X t ) P ( X t , [ X t , h = X t + 1 , h ] ) ) = m i n ( 1 , P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t ) P ( X t ) P ( X t , [ X t , h = X t + 1 , h ] ) ) = m i n ( 1 , 1 ) = 1. \begin{aligned}
\mathcal{A}_{t+1, t} &:= \mathrm{min}\left(1, \frac{P(\boldsymbol{X}_{t+1})q(\boldsymbol{X}_{t}\mid \boldsymbol{X}_{t+1})}{P(\boldsymbol{X}_{t})q(\boldsymbol{X}_{t+1}\mid \boldsymbol{X}_{t})}\right) \\
&= \mathrm{min}\left(1, \frac{P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})P(X_{t, h} \mid \boldsymbol{X}_{t, -h})}{P(\boldsymbol{X}_{t})P(X_{t, h} \mid \boldsymbol{X}_{t, -h})}\right) \\
&= \mathrm{min}\left(1, \frac{P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})P(X_{t, h} \mid \boldsymbol{X}_{t, -h})P(\boldsymbol{X}_{t, -h})}{P(\boldsymbol{X}_{t})P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})}\right) \\
&= \mathrm{min}\left(1, \frac{P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})P(X_{t})}{P(\boldsymbol{X}_{t})P(\boldsymbol{X}_{t, [X_{t, h}=X_{t+1, h}]})}\right) \\
&= \mathrm{min}(1, 1) \\
&= 1.
\end{aligned}
A t + 1 , t := min ( 1 , P ( X t ) q ( X t + 1 ∣ X t ) P ( X t + 1 ) q ( X t ∣ X t + 1 ) ) = min ( 1 , P ( X t ) P ( X t , h ∣ X t , − h ) P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , h ∣ X t , − h ) ) = min ( 1 , P ( X t ) P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , h ∣ X t , − h ) P ( X t , − h ) ) = min ( 1 , P ( X t ) P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t , [ X t , h = X t + 1 , h ] ) P ( X t ) ) = min ( 1 , 1 ) = 1.
所以,对于每一个时刻t t t
Gibbs采样 初始状态为x 0 \boldsymbol{x}_{0} x 0 x t \boldsymbol{x}_{t} x t x t + 1 \boldsymbol{x}_{t+1} x t + 1
均匀的从[ d ] [d] [ d ] h h h
计算q ( X t + 1 ∣ X t ) = P ( X t , [ X t , h = X t , h ] ) P ( X t , − h ) q(\boldsymbol{X}_{t+1} \mid \boldsymbol{X}_{t})= \frac{P(\boldsymbol{X}_{t, [X_{t, h}=X_{t, h}]})}{P(\boldsymbol{X}_{t, -h})} q ( X t + 1 ∣ X t ) = P ( X t , − h ) P ( X t , [ X t , h = X t , h ] )
通过q ( X t + 1 ∣ X t ) q(\boldsymbol{X}_{t+1} \mid \boldsymbol{X}_{t}) q ( X t + 1 ∣ X t ) h h h x t + 1 , h x_{t+1, h} x t + 1 , h
x t + 1 ← x t , [ x t , h = x t + 1 , h ] x_{t+1} \gets \boldsymbol x_{t, [x_{t, h}=x_{t+1, h}]} x t + 1 ← x t , [ x t , h = x t + 1 , h ]
最后一步,是将第d d d
import random
import math
from scipy. stats import beta
from scipy. stats import norm
import matplotlib. pyplot as plt
from mpl_toolkits. mplot3d import Axes3D
from scipy. stats import multivariate_normal
samplesource = multivariate_normal( mean= [ 5 , - 1 ] , cov= [ [ 1 , 0.5 ] , [ 0.5 , 2 ] ] )
def p_ygivenx ( x, m1, m2, s1, s2) :
return ( random. normalvariate( m2 + rho * s2 / s1 * ( x - m1) , math. sqrt( 1 - rho ** 2 ) * s2) )
def p_xgiveny ( y, m1, m2, s1, s2) :
return ( random. normalvariate( m1 + rho * s1 / s2 * ( y - m2) , math. sqrt( 1 - rho ** 2 ) * s1) )
N = 5000
K = 20
x_res = [ ]
y_res = [ ]
z_res = [ ]
m1 = 5
m2 = - 1
s1 = 1
s2 = 2
rho = 0.5
y = m2
for i in range ( N) :
for j in range ( K) :
x = p_xgiveny( y, m1, m2, s1, s2)
y = p_ygivenx( x, m1, m2, s1, s2)
z = samplesource. pdf( [ x, y] )
x_res. append( x)
y_res. append( y)
z_res. append( z)
num_bins = 50
plt. scatter( x_res, norm. pdf( x_res, loc= 5 , scale= 1 ) , label= 'Target Distribution x' , c= 'green' )
plt. scatter( y_res, norm. pdf( y_res, loc= - 1 , scale= 2 ) , label= 'Target Distribution y' , c= 'orange' )
plt. hist( x_res, num_bins, density= 1 , facecolor= 'Cyan' , alpha= 0.5 , label= 'x' )
plt. hist( y_res, num_bins, density= 1 , facecolor= 'magenta' , alpha= 0.5 , label= 'y' )
plt. title( 'Histogram' )
plt. legend( )
plt. show( ) 参考
https://spaces.ac.cn/archives/8084 https://zhuanlan.zhihu.com/p/253784711 Chatgpt